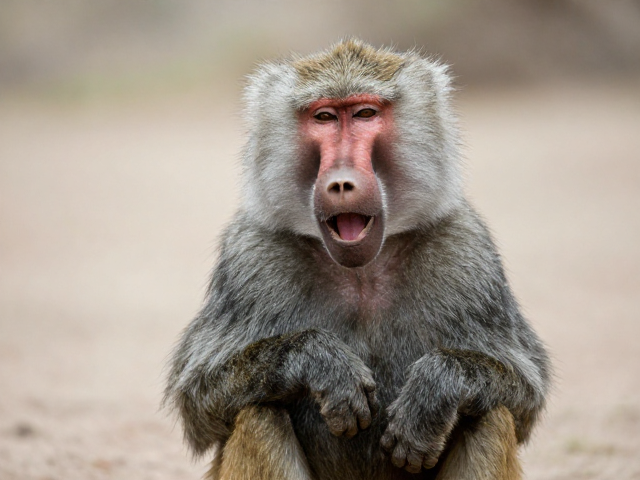
狒狒成体照片与语言模拟,AI如何还原灵长类发声特征
灵长类发声机制与狒狒声学研究基础
狒狒作为旧大陆猴科的重要成员,其发声系统具有严密的生理结构支撑。成年狒狒的喉部结构与鼻腔共鸣腔会共同作用,产生具有高度指向性的警告声、求偶声以及群体间的社会性联络音。研究人员通常利用高灵敏度阵列麦克风在野外自然栖息地记录这些声音,以捕捉未经干扰的原始声学特征。这些录音数据构成了分析灵长类语音复杂性的核心素材,确保了后续模型训练所需的真实性与可追溯性。
现代声学分析技术能够精确提取狒狒叫声中的基频、共振峰以及频谱包络等关键参数。通过长期对野生狒狒种群的观测,生物声学领域已建立起严密的数据库,涵盖了不同性别、年龄及社会地位个体的发声差异。这种基于实证数据的研究路径,使得对狒狒成体声音特征的解构不再依赖主观推测,而是建立在严密的物理声学测量之上,为理解非人类灵长类的交流逻辑提供了坚实的科学依据。
AI声学还原技术的核心逻辑
人工智能在声音还原领域的应用,主要依赖于深度学习算法对海量音频数据的特征提取与重构。通过卷积神经网络等模型,系统能够识别出声带振动模式与声道形状对声波产生的具体影响。在处理狒狒等动物的声音时,算法需要区分背景噪音、环境反射以及主体发声信号,从而剥离出行声本底,还原出口腔与喉部互动的真实声学表现。这一过程并非简单的声音合成,而是对发声生理机制的数字映射。
针对狒狒成体照片与声音的联合模拟,多模态学习技术起到了关键作用。视觉模型分析狒狒的面部肌肉结构、牙齿排列以及喉部形态,进而推断其发声时的生理约束条件。声学模型则结合这些视觉特征,模拟出口腔开合度对共振峰的影响。这种跨模态的数据融合,使得生成的声音在物理特性上更贴近真实生物发出的声波,而非经过人工修饰的合成音,从而在科学验证层面提升了还原的可信度。
视觉特征与声学特征的映射关系
狒狒成体的面部形态直接决定了其发声的频谱特性。体型较大的雄性狒狒通常拥有更宽阔的喉部和更长的声道,这使其发出的警告声具有更低的基频和更丰富的低频成分。通过高精度三维重建技术,研究人员可以量化不同个体间面部骨骼与软组织的差异,并计算这些形态特征对声波传播路径的影响。这种从视觉形态到声学输出的映射分析,揭示了灵长类发声系统中形态与功能的紧密耦合关系。
在实际模拟过程中,图像数据提供了发声时的动态线索。狒狒在发出嘶嘶声或吠叫时,面部肌肉的紧张程度、牙齿的咬合状态以及耳朵的位置变化,都会改变共鸣腔的体积与形状。AI模型通过逐帧分析视频或静态照片中的微表情与姿态,预测发声瞬间的生理状态,进而调整声学参数。这种基于视觉线索的声学推断,使得模拟出的声音能够反映狒狒在特定情境下的生理反应,增强了声音特征与生物行为之间的逻辑关联。
科学验证与数据可追溯性
确保模拟结果的真实性,必须依赖于严密的验证体系。研究团队通常采用盲听测试与客观声学指标对比两种方式来评估还原效果。在盲听测试中,熟悉狒狒声音的专家对模拟声音与真实录音进行辨别,以评估听觉自然度。同时,通过计算模拟声音与真实声音在频谱距离、基频轨迹等量化指标上的误差范围,提供可验证的数据支持。这种双重验证机制,杜绝了主观评价的偏差,确保了研究成果的科学严谨性。
所有参与模拟的数据源及处理流程均需符合开放科学的原则,以便同行审查与复现。从录音文件的元数据、预处理步骤到模型架构的选择,相关信息均需详细记录并公开。这种透明度不仅有助于其他研究者评估方法的有效性,也为后续研究提供了可追溯的数据基础。通过严格遵循科学规范,AI在灵长类发声特征还原领域的应用得以在可信的轨道上推进,为生物学与计算机科学交叉领域的探索提供了可靠的技术路径。