全球种群数量普查,人工林与农田交错带计数指南
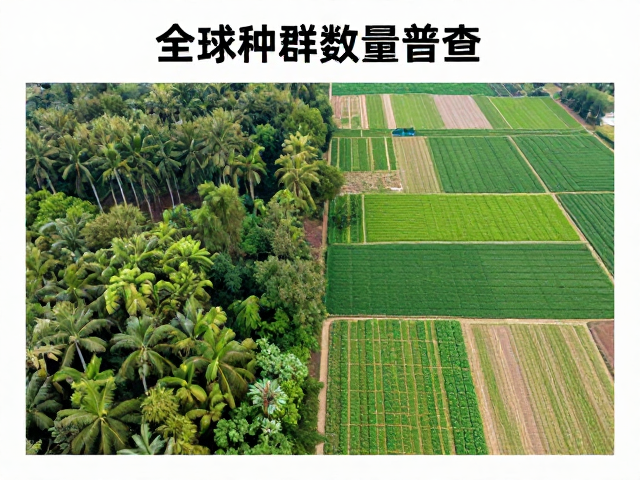
人工林与农田交错带的生态特征与监测挑战
人工林与农田交错带是陆地生态系统中具有显著过渡性质的景观单元,其生物群落结构呈现出高度的异质性。这一区域不仅承载着林业生产与农业耕作的双重功能,更是多种野生动物迁徙、觅偶及栖息的关键廊道。由于植被覆盖类型在短距离内发生剧烈变化,传统单一生境的监测方法难以准确捕捉该区域的生物多样性全貌,导致种群数量评估存在较大偏差。
监测工作的核心难点在于生境边缘效应的复杂性。光照、湿度及微气候条件在林田交界处会发生显著改变,进而影响鸟类、昆虫及小型哺乳动物的分布格局。此外,季节性农事活动与林业采伐作业的时间错位,使得种群处于动态波动中。因此,建立标准化的计数指南必须涵盖不同季节、不同植被结构下的观测策略,以确保数据在不同时间维度下的可比性与科学性。
标准化调查方法与数据采集规范
针对交错带特殊的生境结构,建议采用样线法与定点观测相结合的综合调查模式。在人工林内部,应依据林龄、树种组成划分标准样地,记录乔木层与灌木层的覆盖度;在农田区域,则需重点统计作物类型、收割时间及田间残留物情况。调查人员需使用高精度GPS设备记录每一个观测点的坐标,并同步采集环境因子数据,如土壤湿度、植被高度及人为干扰强度,为后续种群密度校正提供多维度的环境变量支持。
数据采集过程中需严格遵循时间窗口管理原则。鸟类监测通常选择在清晨日出后三小时内进行,此时动物活跃度最高且环境噪音较低;昆虫与无脊椎动物调查则需避开正午高温时段,选取阴天或傍晚进行。所有观测数据应实时录入标准化电子表格,包括物种名称、个体数量、行为特征(如鸣叫、觅食、飞行)以及生境类型代码。数据录入后需经过双人复核机制,剔除因视觉误差或误判导致的异常值,确保基础数据的准确性与完整性。
数据处理模型与种群估算逻辑
原始观测数据需经过严密的统计学处理,以消除观测者个体差异及环境随机性带来的误差。常用方法包括距离采样法(Distance Sampling),该方法通过记录观测点到目标个体的垂直或水平距离,构建检测函数,从而估算出未被发现个体的数量,提高种群密度估算的置信区间。对于隐蔽性较强的物种,可引入标记重捕法或环境DNA(eDNA)技术,通过分析土壤或水体样本中的遗传物质,间接反映种群的存在情况与相对丰度。
在获得基础密度数据后,需结合土地利用类型面积进行空间叠加分析。利用地理信息系统(GIS)平台,将人工林面积、农田面积及交错带缓冲区的精确边界进行整合,计算各生境单元内的种群总数。不同物种对生境的偏好差异需通过广义线性模型(GLM)进行校正,例如某些林缘鸟类更倾向于在靠近农田边缘的树林中活动,而农田专化物种则集中在耕作区内。通过多变量回归分析,剥离出色块效应与季节性波动,最终生成高精度的区域种群数量普查报告。